A Tonga átmentett tudása
Az AMD a Fiji lapkában is a GCN architektúrát alkalmazza, ezen belül is a Tonga cGPU-ban már bemutatkozott GCN3 (V.I. azaz Volcanic Islands) verziót, amelynek publikus dokumentációja egy ideje már elérhető.
Hirdetés
A grafikus vezérlőben 64 darab CU van, és ezek egyenként tartalmaznak egy skalár feldolgozót, illetve négy darab, egymástól teljesen független, 16 utas, azaz 512 bites, multiprecíziós SIMD motort. Egy CU-n belül 64 kB-os Local Data Share (LDS) található, melyen a négy darab, egyenként 64 kB-os regiszterterülettel rendelkező SIMD motor osztozik. Az LDS-sel az AMD – szokásához híven – túlteljesíti a DirectCompute 32 kB-os követelményét, aminek az a magyarázata, hogy az architektúrát általános számításokra tervezték, illetve a manuális interpoláció számára is szükséges némi gyorsan elérhető memóriaterület. Az AMD az LDS-t szokás szerint virtualizálja, tehát a különböző feladatok egymás adatait nem bánthatják, ezzel egyetemben a rendszer megörökölte a korábbi lapkáktól azt a tulajdonságot, amelynek hála a CU-kon belüli LDS-t a geometry shaderek adatainak mentésére is lehet használni. Az LDS mellett természetesen egy 16 kB-os adat gyorsítótár is elérhető, melyet a CU írhat és olvashat is.
A fentebb már említett skalár feldolgozó némileg különc a CU-n belül. Ez lényegében egy integer ALU, mely 8 kB-os dedikált regiszterterületet kapott. A textúrázást CU-nként egy blokk oldja meg, mely négy darab, csak szűrt mintákkal visszatérő Gather4-kompatibilis textúrázó csatornát rejt. A lapkán belül négy CU egy tömbbe rendeződik, és ehhez tartozik egy 16 kB-os skalár és egy 32 kB-os utasítás gyorsítótár. Előbbit csak a skalár feldolgozó éri el, míg utóbbit a CU összes feldolgozója hasznosíthatja, de természetesen mindkét gyorsítótár írható és olvasható is.

A Fiji cGPU blokkdiagrammja [+]
A Fiji az órajelenként négy háromszöggel dolgozó setup motort is megörökölte a Tonga cGPU-ból, annak minden előnyével együtt. A négy darab tesszellátor tizenegyedik generációs megoldás, míg a szintén négy darab raszter motor egyenként, órajelenként 16 képpontot dolgoz fel, vagyis összesen 64 képpontot. A memóriavezérlőhöz egy 2 MB kapacitású, írható és olvasható másodlagos gyorsítótár és 8 darab ROP-blokk kapcsolódik, ami így összesen 64 blending és 256 Z mintavételező egységet eredményez. Látható az is, hogy a blending egységek száma, illetve a raszter motorok teljesítménye szinkronban van.
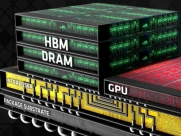
Fontos megjegyezni, hogy a HBM memóriára való áttérés miatt a memóriavezérlőt némi átalakítás érte. Ezzel kapcsolatban megtudtuk, hogy az AMD a korábbi döntéseknek hála könnyen átállhatott, mert az évek óta alkalmazott control hub nagyon illik a HBM-hez. Mint ismeretes, a korábbi memóriaszabványoknál maguk a memóriák 32 bites busszal kapcsolódtak a lapkához, persze párosával, így a memóriavezérlők 64 bitesek voltak. Ezt relatíve egyszerű volt crossbar módszerrel kezelni, hiszen kis szélességű összeköttetésekre volt szükség, és ebből bőven elfért egy csomó az adott lapkán belül. Még olyan tranzisztorkímélő optimalizálásokat is be lehetett vetni, hogy a keresztirányú összeköttetések nem 64, hanem csak 32 bitesek, és ez a gyakorlatban nem igazán jelentet teljesítményhátrányt.
Az AMD-nek a control hubra vonatkozó ötlete, vagyis az, hogy legyen egy nagy széles busz a memóriavezérlők és az L2 gyorsítótárak között ugyan nem volt rossz, hiszen így is lehetett vele tranzisztorokat spórolni lényegében mindenféle negatív mellékhatás nélkül, de radikális előrelépést nem jelentett a DDR3 és a GDDR5 memóriák mellett. Ez a HBM-mel azonban teljesen megváltozik, mivel mostantól a memóriavezérlők egyenként 512 bitesek, vagyis a crossbar módszer itt már rendkívül tranzisztorpazarló lenne, de a control hubbal lényegében ezt a hátrányt nem kell felvállalnia az AMD-nek.
A dupla pontossággal kapcsolatban a hardver képes az elméleti számítási teljesítmény tizenhatod részével elvégezni a feladatokat, vagyis ebből a szempontból elég korlátozott megoldásnak számít, de erre a lapkára csak Radeon fog épülni, tehát nincs jelentősége a döntésnek. Van viszont támogatás a 16 bites lebegőpontos utasítások teljes értékű feldolgozására vonatkozóan, ami már a játékosok számára is lényeges szempont, hiszen számos feladat nem igényel 32 bites precizitást, így energiát lehet spórolni, miközben gyorsul is a hardver. Utóbbi egyébként opcionális DirectX 12-es követelmény, amit az AMD annyira nem szokott hangoztatni, de az Intel nagyon erősen kardoskodik használatáért a fejlesztőknél.
Szintén megjegyzendő, hogy a Fiji is megkapta a Tonga cGPU-ban bemutatkozott Delta Color Compression technikát a temérdek memória-sávszélesség és pixelkitöltési sebesség mellé, ami növeli a rendszer hatékonyságát.
A Fiji funkcionalitásban a többi GCN architektúrára épülő megoldást másolja, így támogatja a DirectX 11.2-es, a DirectX 12-es, az OpenGL 4.5-ös, az OpenGL ES 3.0-s és a Mantle API-t, emellett kezeli a C++ AMP-t és az OpenCL 2.0-es felületet. Később támogatni fogja a Vulkan API-t is.
A lapka kapott új UVD motort, mely a Tonga cGPU-ban bevezetett 6-os verzióhoz képest már támogatja a HEVC formátumú 4K-s videók dekódolását is. A VCE 3.1-es blokk lényegében ugyanazt tudja, amit a Tonga cGPU megoldása, vagyis a legtöbb korábbi Radeon VGA-hoz képest 12-szer gyorsabban dolgozik, illetve képes 4K-s H.264-es videókat is kódolni. Mindemellett természetesen a TrueAudio hangprocesszor is a lapka része, amelyhez jelen állás szerint az év későbbi részében új játékok is érkeznek.
A cikk még nem ért véget, kérlek, lapozz!